E-NEWSLETTER No.186 October
- 기획특집 / 대한의학회의 과거 60년과 현재 조명 / 이윤성(서울의대 명예교수)
- 오피니언 / 국가통합바이오빅데이터, 구축과 활용의 선순환을 위하여 / 백롱민 (국가통합바이오빅데이터구축사업단장)
- 의료와 테크 / 수면을 기록하는 시계에서, 건강을 예측하는 시계로 / 김재경(KAIST 수리과학과 부교수)
- 의료와 인문 / 알고리즘이 보지 못하는 환자 / 이원복(이화여자대학교 법학전문대학원 교수)
- 의학회 브리핑(1) / 대한의학회 창립 60주년, 새로운 60년을 위한 특별한 동행
- 의학회 브리핑(2) / 60년의 발자취를 한 권에 담다 / 『대한의학회 60년사』 발간
의료와 인문
◎ 알고리즘이 보지 못하는 환자
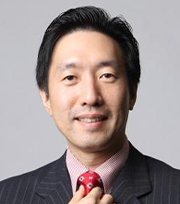
이 원 복이화여자대학교 법학전문대학원 교수
필자가 인공지능과 의료의 문제를 붙들고 지내다 보니, 사람들에게 가장 자주 받는 질문은 "AI가 의사를 대체하겠느냐"는 것이다. 그런데 정작 필자를 오래 붙잡아 둔 질문은 다른 쪽에 있다. AI가 잘 진료하는 환자와 잘 진료하지 못하는 환자가 따로 있다면, 우리는 그 경계선을 어디서 찾아야 하는가.
이 질문이 세상의 주목을 받게 된 계기는 2019년 Science에 실린 Obermeyer팀의 연구였다. 미국의 여러 병원에서 쓰이던 상업용 알고리즘이 환자의 건강 필요를 예측하면서, 같은 건강 상태의 흑인 환자를 백인 환자보다 덜 아픈 사람으로 계산하고 있었다. 알고리즘이 인종이라는 변수를 쓴 것도 아니었다. 미래의 의료비 지출을 건강 필요의 대리 지표로 삼았을 뿐인데, 의료 접근성이 낮아 돈을 덜 쓰는 집단이 그만큼 건강한 집단으로 둔갑해 버린 것이다. 악의를 가진 사람은 어디에도 없었다. 그저 데이터가 우리 사회의 모습을 충실히 배웠을 뿐이다.
이 사건 이후 의료 AI의 '공정성 검증'은 하나의 연구 분야가 되었다. 알고리즘을 시장에 내놓기 전에 집단별 성능을 재어 보는 것이다. 그런데 검증의 자를 대는 순간 곤란한 질문이 하나 따라온다. 어느 집단을 재어 볼 것인가. 인종과 성별은 누구나 떠올린다. 그러면 소득은? 거주 지역은? 언어는? 유방촬영 AI가 침윤암보다 상피내암을 잘 놓친다면, 뇌출혈 판독 AI가 급성기 출혈보다 아급성기 출혈에 약하다면, 그것도 같은 저울에 올려야 하는가. 실제로 최근의 실사용 데이터 연구들은 이런 임상적 하위집단에서의 성능 저하를 반복해서 보고하고 있다.
흥미로운 것은 이 질문 앞에서 우리의 마음이 균일하게 움직이지 않는다는 점이다. 저소득층 환자에게서 알고리즘이 유독 부정확하다는 이야기를 들으면 많은 이들이 부당하다고 느낀다. 그런데 특정 병기의 환자에게서 부정확하다는 이야기는, 심각한 문제라고 생각하면서도 '불공정'이라는 단어까지는 잘 꺼내지 않는다. 같은 크기의 성능 저하인데 왜 어떤 것은 차별처럼 느껴지고 어떤 것은 기술적 한계처럼 느껴지는가. 필자는 이 직관의 갈림 자체가 우리에게 무언가를 말해주고 있다고 생각한다. 우리가 '공정'이라는 말로 지키려는 것이 단순한 수치의 균등이 아니라, 이미 아픈 자리에 또 하나의 불이익이 얹히지 않아야 한다는 감각이라는 것을.
여기서 의료인문사회과학의 오래된 물음과 만나게 된다. 의학은 언제나 평균의 학문이면서 동시에 개별자의 학문이었다. 임상시험은 평균적 환자에게서 효과를 증명하지만, 진료실에 앉아 있는 것은 평균이 아닌 한 사람이다. 좋은 의사는 자신의 지식이 어떤 환자에게서 만들어졌고 어떤 환자에게는 잘 들어맞지 않는지를 늘 의식해 왔다. 교과서가 백인 남성의 심근경색 증상을 전형으로 기술하던 시절, 여성 환자의 비전형적 흉통을 놓치지 않으려 애쓰던 감각이 그것이다. 의료 AI의 편향 문제는 완전히 새로운 문제가 아니라, 이 오래된 감각을 기계의 시대에 다시 묻는 일인지도 모른다. 다만 규모가 달라졌다. 한 의사의 맹점은 그의 진료실에 머물지만, 하나의 알고리즘에 새겨진 맹점은 그 알고리즘이 배포된 모든 병원에서 동시에, 조용히 작동한다.
그래서 필자는 의료 AI 시대에 의사에게 요구되는 덕목 하나가 추가되었다고 생각한다. 도구의 성능을 묻는 데서 멈추지 않고, 그 성능이 '누구에게서 측정된 것인지'를 묻는 습관이다. 민감도 96%라는 숫자를 들으면 어떤 환자들로 구성된 96%인지 물어보는 것. 우리 병원의 환자군이 그 숫자를 만든 환자군과 얼마나 닮았는지 가늠해 보는 것. 그리고 알고리즘이 자신 없어 하는 자리, 즉 데이터가 드물었던 환자들 곁에서는 오히려 사람의 눈이 더 오래 머물러야 한다는 것을 기억하는 것이다.
인공지능은 다수의 경험을 놀랍도록 잘 압축한다. 그러나 압축이라는 말 속에는 잘려 나간 소수가 있다. 의학이 인문사회과학을 필요로 하는 이유가 인간을 이해하기 위해서라면, 의료 AI의 시대에 그 이해는 한 문장으로 좁혀지는 것 같다. 알고리즘이 보지 못하는 환자를 보는 것. 그것은 예나 지금이나 기계가 아니라 의사의 일이다.
- 대한의학회(https://www.kams.or.kr)
-
(06653) 서울특별시 서초구 반포대로 14길 42, 6층/7층 (서초동, 하이앤드타워)
- T. 02-798-3807
- F. 0502-798-3807
- E-mail : newsletter@kams.or.kr

